전자제품에 화면만 달려 있으면 일단 둠(Doom)부터 돌려 본다는 말이 있습니다. 1993년에 나온 슈팅 게임 둠을 그래픽 계산기나 ATM, 심지어 전동칫솔에서까지 실행해 보는 오래된 인터넷 밈인데요.
지난 9월, 이 전통에 특이한 도전자가 나타났습니다. 미국 스타트업 타입세이프 AI(TypeSafe AI)가 공개한 제브(Jev)입니다. 화면을 보지 않고 말도 하지 않는 이 AI는 상황을 적은 텍스트만 받아 초당 약 10번 다음 행동을 골랐습니다.
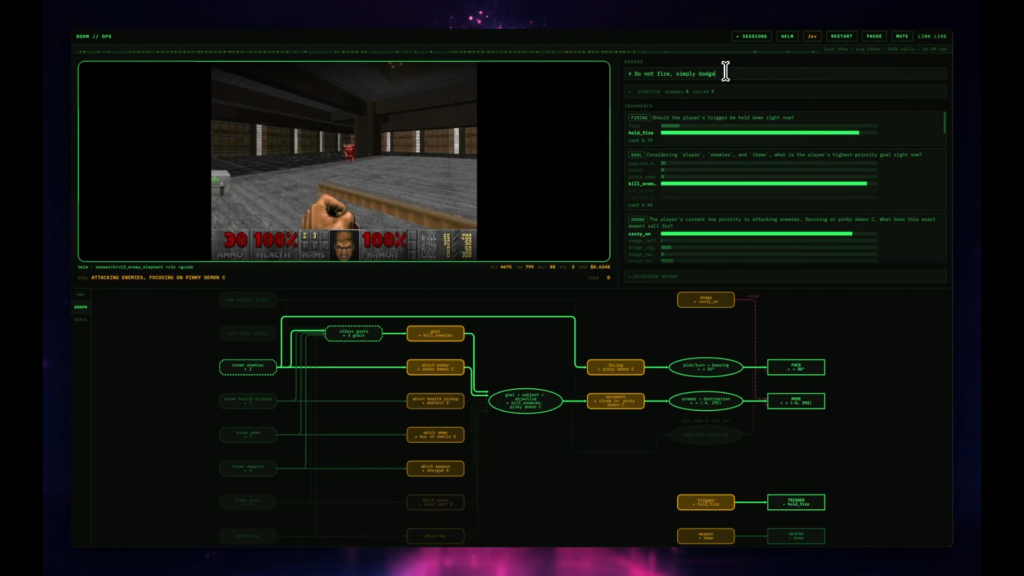
Jev가 게임 상황을 텍스트로 받아 둠을 플레이하는 데모 화면. 출처: TypeSafe AI, Introducing System One Models & Jev, 2026
이렇게 한 시간을 플레이하는 데 든 비용은 약 7달러였습니다. 게임 실력보다 눈여겨볼 건 AI가 이만큼 빠르고 저렴하게 판단을 내렸다는 점이지요. Jev는 대체 어떤 AI이길래 이런 일이 가능했을까요? 오늘은 Jev가 속한 '의사결정 모델'이 무엇인지 알아보고, 셀렉트스타가 만든 의사결정 모델 다비(Davi)는 Jev와 무엇이 다른지 살펴보겠습니다.
Jev는 왜 이렇게 화제가 됐을까?
Jev는 타입세이프 AI가 2026년 9월 15일 얼리 액세스로 공개한 모델입니다. 창업자 디오고 알메이다(Diogo Almeida)는 오픈AI에서 인간 피드백 기반 강화학습(RLHF) 개발에 참여한 연구자로 알려져 있습니다. 2년간의 비공개 개발 끝에 4,000만 달러 시드 투자 소식과 함께 Jev를 내놓았습니다.
Jev가 주목받은 이유는 단순합니다. 말을 하지 않습니다. 질문을 받으면 문장을 만드는 대신, 미리 정해 둔 선택지 중 하나와 그 확률을 출력합니다. 타입세이프가 공개한 데모에서 Jev는 같은 질문 27개를 0.114초 만에 처리했습니다. 오픈AI의 GPT-5.6 Terra는 8.566초가 걸렸는데요. 약 75배 빠르고 비용은 171분의 1 수준이었습니다. 회사 측 설명에 따르면 응답 시간은 대체로 70~500밀리초 수준입니다.
시장의 반응도 빨랐습니다. 공개 한 달도 안 된 10월 9일, 블룸버그는 타입세이프가 약 8억 7,000만 달러를 추가로 투자받아 기업가치 75억 달러를 인정받았다고 보도했습니다.
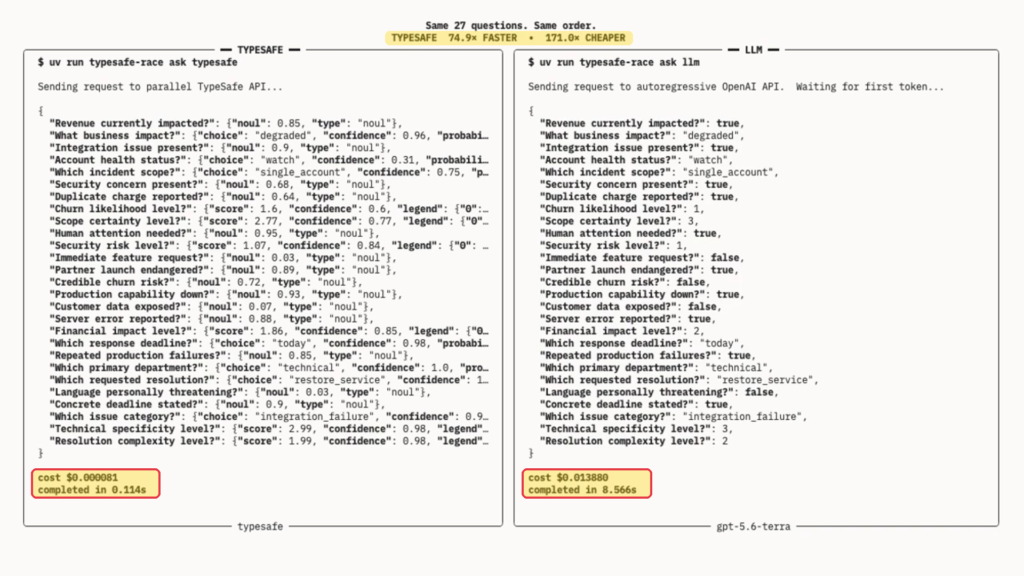
타입세이프가 공개한 응답 속도 데모. 같은 질문 27개를 처리하는 데 Jev는 0.114초, GPT-5.6 Terra는 8.566초가 걸렸습니다. 강조 표시는 원본에 덧붙였습니다. 출처: TypeSafe AI, 웹사이트 데모, 2026
의사결정 모델이란?
Jev처럼 문장 대신 판단을 내리는 모델을 의사결정 모델(Decision Model)이라고 부릅니다. 의사결정 모델은 입력을 보고 선택지 하나, 점수, 또는 확률을 반환하는 AI 모델입니다. 즉, 답을 '쓰는' 대신 '고르는' 모델이지요.
회사 결재로 비유해 볼까요? LLM이 보고서를 써 오는 담당자라면, AI 에이전트는 자료 조사부터 보고서 작성까지 여러 단계를 혼자 처리하는 실무자에 가깝습니다. 의사결정 모델은 결재란에 '승인' 도장을 찍으며 "이 판단은 90% 확신합니다"라고 적는 결재자고요. 보고서는 사람이 읽기 위한 것이지만, 도장은 다른 프로그램이나 AI가 받아 곧바로 다음 절차를 이어 가는 데 쓰입니다. 답이 짧은 만큼 시간과 비용도 가장 적게 듭니다.
의사결정 모델이 가장 힘을 발휘하는 곳은 LLM 옆입니다. AI 에이전트가 일하는 동안에는 "이 결과를 믿어도 될까?", "지금 멈추고 다시 시켜야 할까?", "이 문의는 어느 부서로 보낼까?" 같은 작은 판단이 끊임없이 필요한데요. 이 판단을 매번 큰 LLM에게 묻는 대신 의사결정 모델에 맡기면, 에이전트 전체가 훨씬 빠르고 가벼워집니다.
물론 빠르다고 다가 아닙니다. 게임에서야 한 발 빗나가도 다시 쏘면 되지만, 고객 문의를 엉뚱한 부서로 보내는 일은 고스란히 비용이 되지요. 게다가 의사결정 모델은 판단의 이유를 문장으로 설명하지 않습니다. 그래서 어떤 판단을 맡길지, 그 판단이 얼마나 정확한지를 미리 확인해 두는 일이 더 중요해집니다.
셀렉트스타가 만든 의사결정 모델, Davi
AI를 평가하는 일의 핵심은 판정입니다. "이 답변은 맞았는가", "이 근거는 질문과 관련 있는가", "이 작업은 성공했는가"를 정확하게, 그리고 매번 같은 기준으로 가려내는 일이지요. AI 신뢰성 평가를 해 온 셀렉트스타에게 의사결정 모델이 낯설지 않은 이유입니다.
셀렉트스타 AI 연구팀이 만든 다비(Davi)는 이런 판정에 특화된 의사결정 모델입니다. Jev처럼 문장 대신 판단과 확률을 출력하는데요. 연구팀은 Davi 0.2.0을 Jev 1.13.0과 같은 벤치마크, 같은 조건에서 비교했습니다.
Davi가 겨냥하는 판단은 크게 네 가지입니다.
- 분류: 사용자의 짧은 요청을 보고 의도를 고르는 일입니다. "내일 7시에 깨워줘"를 '알람 설정'으로 분류하거나, 고객 문의를 담당 부서로 보내는 일이 대표적입니다.
- 채점: AI가 내놓은 답변이 기준에 맞는지, 검색해 온 문단이 질문과 관련 있는지 점수를 매기는 일입니다.
- 예측: AI 에이전트가 일하는 도중에 "이대로 가면 결국 성공할까?"를 미리 가늠하는 일입니다.
- 배정: 작업마다 어떤 모델에 맡기면 충분한지 판단하는 일입니다. 쉬운 질문은 가볍고 저렴한 모델에, 어려운 질문은 강력한 모델에 보내는 식이지요.
네 가지 모두 AI 에이전트와 서비스가 실제로 운영될 때 하루에도 수없이 반복되는 판단인데요. 아래에서는 판정 능력 전반부터 시작해, 이 네 가지 판단에서 Davi와 Jev가 어떻게 달랐는지 차례로 살펴보겠습니다.
가장 빠른 AI 뉴스
Davi는 어떤 판단에 강할까?
Davi와 Jev를 9개 지표로 비교한 결과, Davi는 8개 지표에서 Jev보다 높은 점수를 기록했습니다. 먼저 아래 그래프로 전체 결과를 훑어본 뒤, 여섯 가지 평가를 하나씩 나눠 자세히 살펴보겠습니다. 그래프는 지표마다 Davi 점수에서 Jev 점수를 뺀 차이로, 오른쪽으로 길수록 Davi가 더 높았다는 뜻입니다.
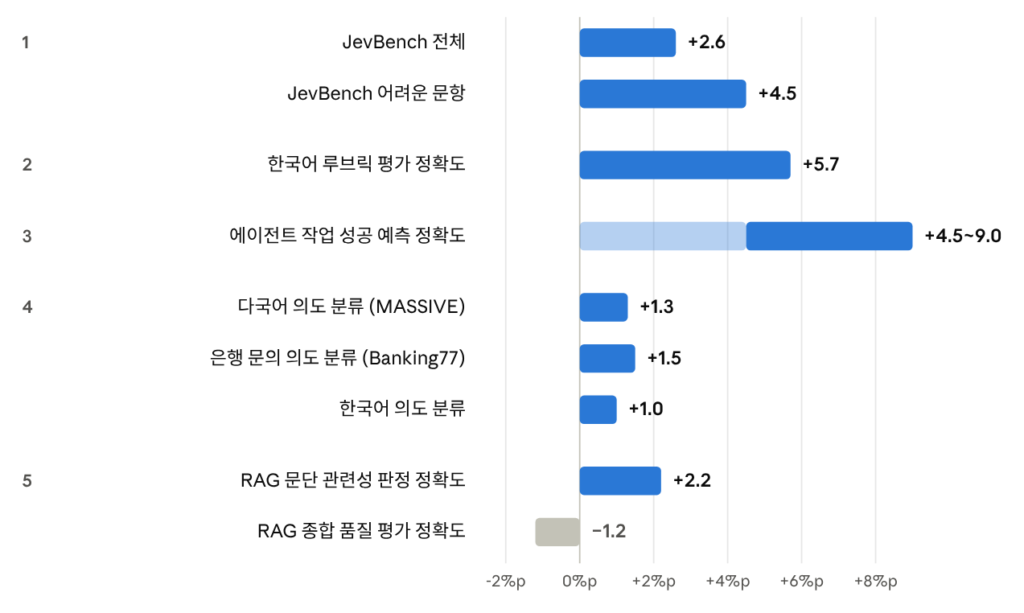
지표별 Davi와 Jev의 점수 차이. 에이전트 작업 성공 예측 정확도는 6개 조건의 차이 범위입니다. 출처: 셀렉트스타 AI 연구팀, Davi vs Jev 비교 평가
1. 같은 종류의 판정 시험에서 Jev를 앞섰다
JevBench는 Jev 개발사와 무관한 외부에서 판정 모델 비교용으로 만든 231문항짜리 공개 벤치마크입니다. 예/아니오, 보기 고르기, 점수 매기기처럼 판정 모델이 실제로 하는 일을 골고루 묻지요.
Davi는 전체 문항에서 89.2%를 맞혀 Jev(86.6%)보다 2.6%p 높았습니다. 차이는 여러 조건을 따지거나 함정이 있는 어려운 문항 111개에서 더 벌어졌는데요. 여기서 Davi는 77.5%로 Jev(73.0%)보다 4.5%p 높았습니다. 다만 문항 수가 231개로 많지 않아 이 정도 차이가 우연히 생겼을 가능성을 완전히 배제할 수는 없습니다.
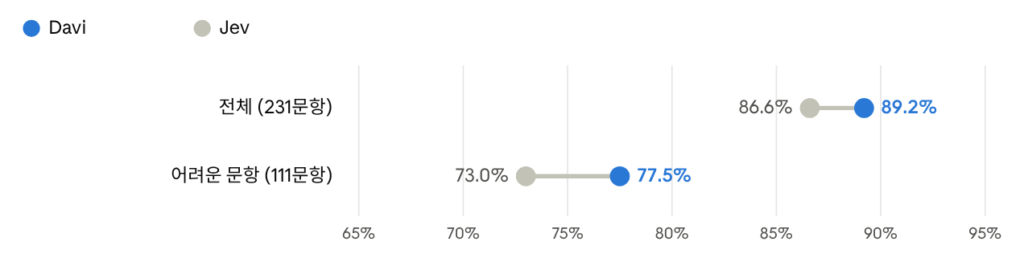
JevBench 전체 문항과 어려운 문항의 정확도. 출처: 셀렉트스타 AI 연구팀, JevBench 평가
2. 한국어 루브릭 평가에서 5.7%p 차이를 냈다
Ko Feedback Bench는 셀렉트스타 연구팀이 2026년 GEM 워크숍 논문에서 공개한 한국어 벤치마크입니다. AI가 루브릭, 즉 채점 기준표에 따라 답변을 얼마나 정확히 채점하는지 보는데요. 영어 Feedback Bench 1,000문항을 한국어로 옮겼고 감정 소통이나 오류 대응 같은 10개 카테고리를 다룹니다.
여기서 Davi는 72.5%로 Jev(66.8%)보다 5.7%p 높았습니다. 한국어 서비스를 운영하는 기업이 AI 답변 품질을 자동으로 점검하려 할 때, 판정 모델이 한국어를 얼마나 정확히 읽어 내는지가 곧 점검 결과의 신뢰도로 이어집니다.
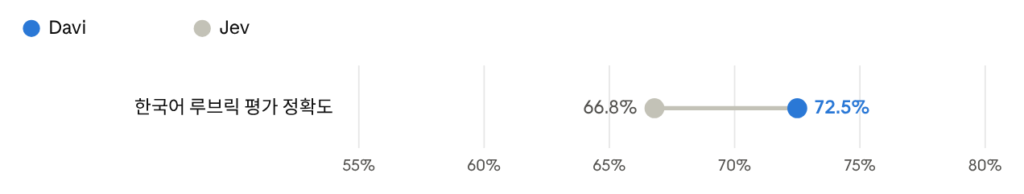
Ko Feedback Bench에서 두 모델이 기록한 한국어 루브릭 평가 정확도. 출처: 셀렉트스타 AI 연구팀, Ko Feedback Bench 평가
3. 작업이 끝나기 전에 실패를 먼저 알아챘다
AI 코딩 에이전트가 깃허브 버그 수정 요청을 처리한 기록을 25%, 50%, 75% 지점에서 잘라 보여 주고, "이대로 가면 결국 성공할까?"를 예측하게 한 평가입니다. 정답은 실제 테스트 통과 여부로 정했습니다.
성공률이 다른 두 종류의 에이전트와 세 시점을 조합한 6개 조건 모두에서, Davi는 Jev보다 4.5~9.0%p 높았습니다. 작업이 끝나기 전에 "이건 실패할 것 같으니 지금 멈추고 다시 시작하자"고 판단할 수 있다면, 그만큼 시간과 비용을 아낄 수 있습니다.
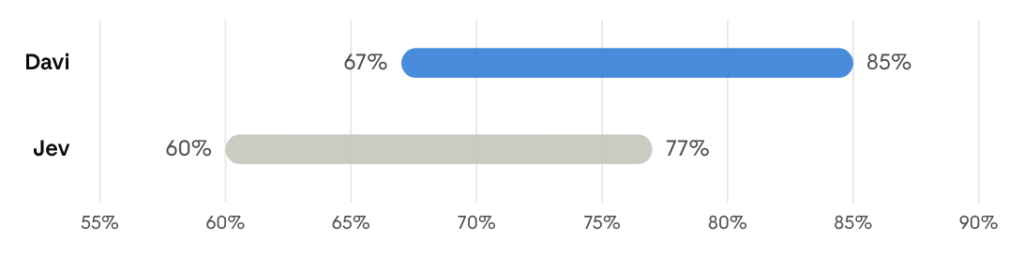
에이전트 작업 성공 예측 6개 조건에서 두 모델이 기록한 정확도 범위. 출처: 셀렉트스타 AI 연구팀, 에이전트 작업 판정 평가
4. 51개 언어와 은행 상담 문의에서도 의도를 더 정확히 골랐다
분류 과제는 세 가지로 확인했습니다. 아마존이 공개한 MASSIVE는 음성 비서에게 한 짧은 말을 보고 의도를 고르는 문제로, 한국어를 포함한 51개 언어로 출제됩니다. Banking77은 은행 고객 문의를 77개 의도로 나누는 데이터셋입니다.
세 과제 모두 Davi가 1.0~1.5%p 앞섰습니다. 차이가 커 보이지 않을 수 있지만 고객 문의 분류처럼 같은 판단이 대량으로 반복되는 일에서는 1%p가 1만 건 중 100건의 차이가 됩니다.
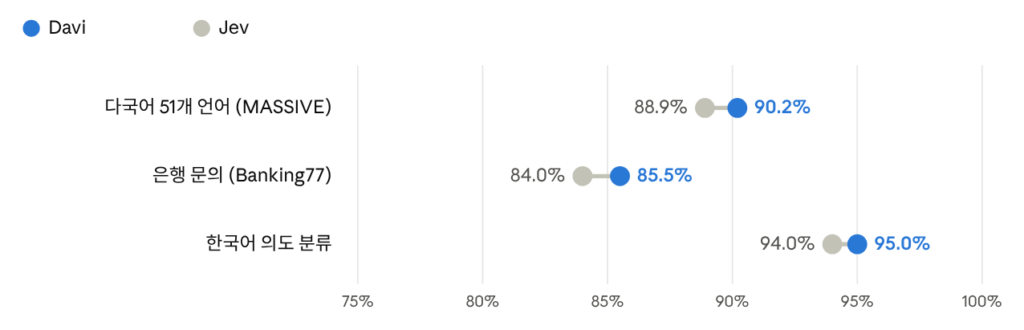
세 가지 의도 분류 과제의 정확도. 출처: 셀렉트스타 AI 연구팀, MASSIVE, Banking77, 한국어 의도 분류 평가
5. RAG 종합 품질 평가는 보완 과제로 남았다
RAG(검색 증강 생성)는 AI가 외부 문서를 찾아 근거로 삼아 답하는 방식입니다. 검색해 온 문단이 질문과 관련 있는지 가려내는 문단 관련성 판정에서는 Davi가 2.2%p 앞섰는데요. 답변 품질을 6개 과제로 나눠 평가한 종합 품질 평가에서는 Jev가 1.2%p 높았습니다. 이번 비교에서 Jev가 앞선 유일한 지표로, 강점과 보완할 점을 함께 보여 주는 편이 판정 모델을 고르는 데 더 쓸모 있다고 보고 결과를 그대로 공개합니다.
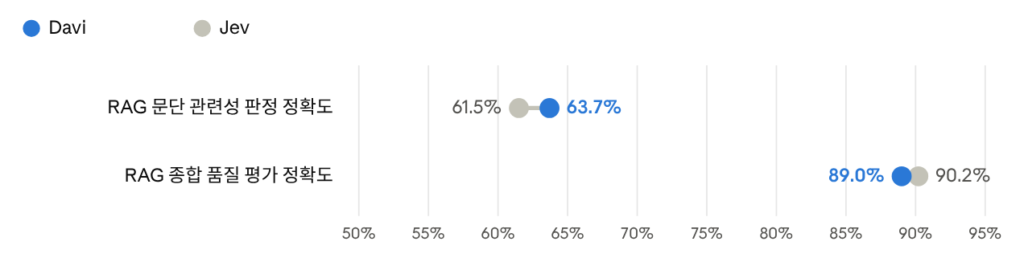
RAG 문단 관련성 판정 정확도와 RAG 종합 품질 평가 정확도. 종합 품질 평가는 6개 과제의 평균입니다. 출처: 셀렉트스타 AI 연구팀, RAG 평가
6. Opus만 쓸 때보다 싸고, 같은 예산에서는 Jev보다 정확했다
Claude에는 빠르고 저렴한 Haiku, 중간급인 Sonnet, 가장 강력하지만 비싼 Opus가 있습니다. 모든 작업을 Opus에 맡기면 정확하겠지만 쉬운 질문에도 비싼 값을 치르게 되지요. 그래서 작업마다 "Haiku로 충분한가, Opus가 필요한가"를 먼저 판단해 알맞은 모델에 맡기는 방식이 쓰이는데요. 이를 모델 라우팅(Model Routing)이라고 합니다. 판정이 정확할수록 정답률은 지키면서 비용은 줄일 수 있습니다.
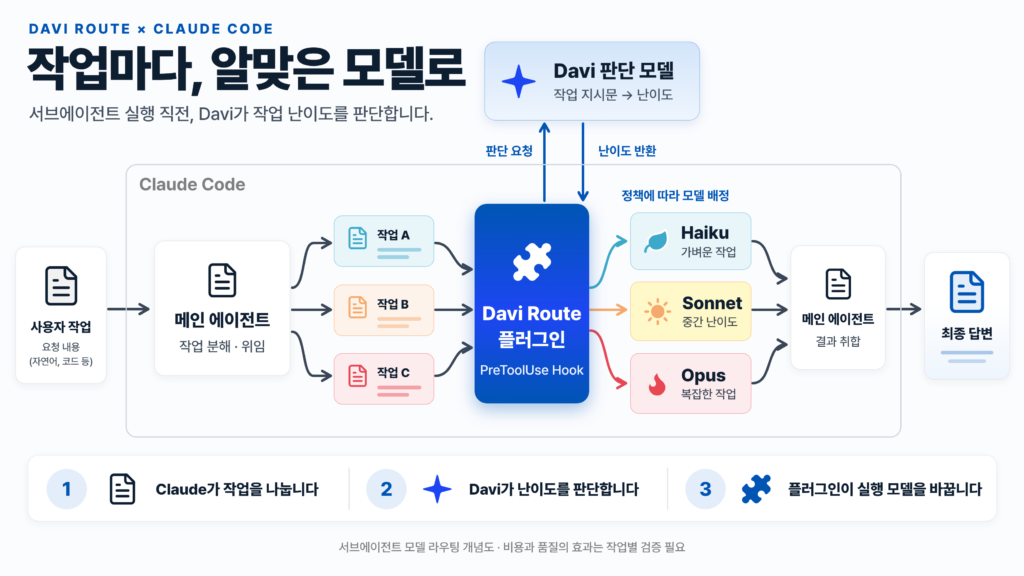
Davi 라우팅 플러그인의 작동 개념도. 출처: 셀렉트스타 AI 연구팀
연구팀은 이를 한국어 고난도 질의응답 데이터 K-HLE로 실험했습니다. K-HLE가 어떤 데이터인지는 지난 글에서 자세히 다뤘지요. "대한민국 현행 민사법 체계에서 '신의성실' 원칙을 조문으로 처음 명시한 법률은 무엇인가?"처럼, 한국 역사와 제도를 깊이 알아야 풀 수 있는 문제들로, 가장 강력한 Opus도 열 문제 중 세 문제는 틀릴 만큼 어렵습니다.
174문항을 외부 검색 없이 다섯 번씩, 총 870건을 풀게 했습니다. 판정자로 Claude Haiku 5.5, Jev, Davi를 각각 세워 문항마다 Haiku, Sonnet, Opus 중 하나로 보내게 하고 한 모델만 쓴 경우와 비교했습니다.
라우팅을 쓰면 이득일까?
라우팅이 없다면 가장 정확한 Opus 하나로 모든 문항을 처리하는 것이 기본값입니다. Davi가 모델을 고르도록 했을 때는 Opus만 쓸 때보다 정답이 7개 많았고 답변 생성 비용은 약 28% 적었습니다. 정답률을 유지하면서 비용을 줄인 셈입니다.
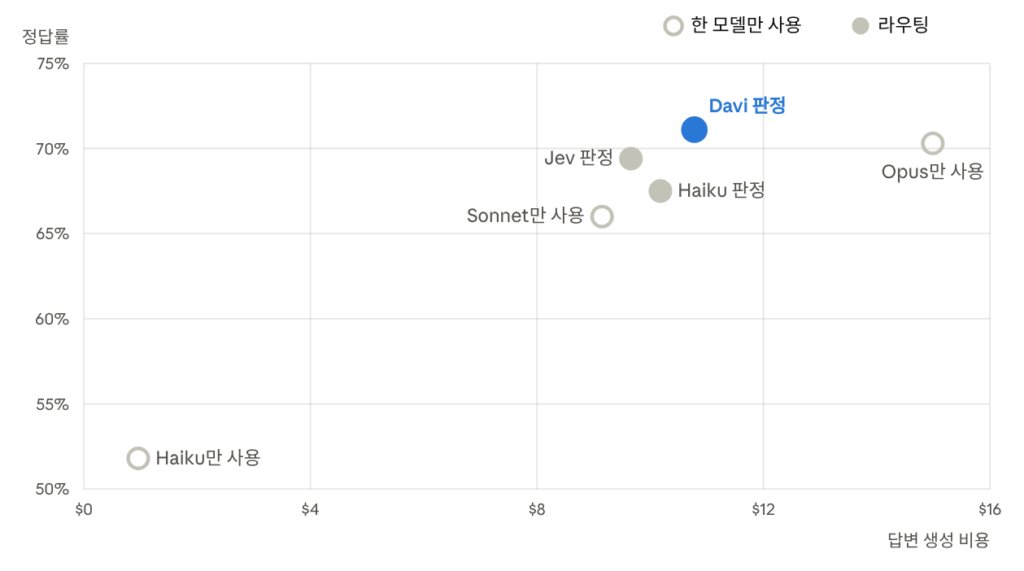
방식별 정답률과 답변 생성 비용. 왼쪽 위에 있을수록 적은 비용으로 더 많이 맞혔다는 뜻입니다. 출처: 셀렉트스타 AI 연구팀, K-HLE 라우팅 실험
판정자로는 누가 더 잘 골랐을까?
위 그래프에서 Davi 판정은 Jev 판정보다 정답이 15개 많았지만 비용도 1.12달러 더 들었습니다. 어느 모델로 보낼지 가르는 기준값을 어떻게 잡느냐에 따라 비용과 정답률은 서로 맞바꿀 수 있는데요. 그래서 판정자의 실력은 같은 예산에서 비교해야 공정합니다. 연구팀은 예산을 Opus만 쓸 때 비용의 80%로 고정하고 결과가 부풀려지지 않도록 기준값은 문항 절반으로 정한 뒤 나머지 절반으로 정답률을 다시 쟀습니다.
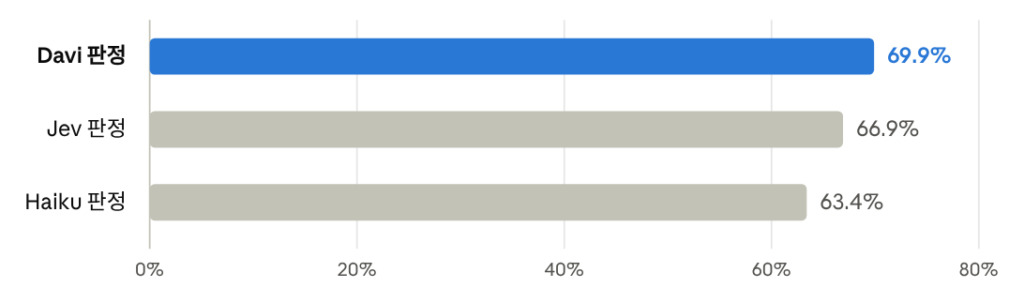
같은 예산에서 판정자별 라우팅 정답률. 출처: 셀렉트스타 AI 연구팀, K-HLE 라우팅 실험
같은 예산에서 Davi 판정의 정답률은 69.9%로, Jev(66.9%)보다 3.0%p, Claude Haiku(63.4%)보다 6.5%p 높았습니다. 같은 돈을 쓴다면 Davi가 더 맞게 모델을 골랐다는 뜻입니다.
판단이 얼마나 한결같은지도 확인했습니다. 같은 174문항을 다섯 번 반복했을 때 고른 모델이 바뀐 문항은 Davi가 2개, Jev가 14개, Claude Haiku가 40개였습니다. 같은 질문에 매번 같은 판단을 내린다면, 운영하는 쪽에서는 비용과 결과를 예측하기가 훨씬 쉬워집니다.
다만 28% 절감은 답변 생성 비용만 정가 기준으로 추정한 수치로, 판정자를 부르는 비용은 빠져 있습니다. 또 한국어 질의응답 한 가지 과제에서 얻은 결과라 코딩이나 긴 에이전트 작업에서도 같은 효과가 나는지는 따로 확인이 필요합니다.
판단을 맡길 수 있어야, 일을 맡길 수 있다
이번 비교에서 눈여겨볼 점은 의사결정 모델끼리도 판단의 정확도에서 차이가 난다는 것입니다. 빠르고 저렴한 건 의사결정 모델이라면 대부분 갖춘 장점이지만, 판단이 틀리면 그 장점은 고스란히 비용으로 돌아옵니다. 한국어 루브릭 평가처럼 언어와 맥락이 얽힌 판단에서 차이가 컸고, 같은 질문에 대한 판단이 얼마나 한결같은지도 모델마다 크게 달랐습니다. 다만 대부분의 차이가 몇 %p 안팎이고 과제마다 강점이 달랐던 만큼, 어떤 판단을 맡길지는 자기 업무 데이터로 직접 확인해 보는 것이 가장 확실합니다.
셀렉트스타는 11월부터 Davi를 AI 신뢰성 평가 플랫폼 다투모 이밸(Datumo Eval)에 적용할 예정입니다. 평가 과정에서 반복되는 수많은 판단을 Davi가 빠르고 저렴하게 맡으면, 다투모 이밸 사용자는 더 적은 비용으로 더 빠르게 평가 결과를 받아 볼 수 있게 됩니다. AI를 평가해 온 셀렉트스타가 직접 만든 판정 모델로, AI 평가 자체를 더 가볍고 빠르게 만드는 것이 목표입니다.
Davi, 깃허브에서 바로 써 보세요
앞에서 살펴본 모델 라우팅은 Claude Code에서 직접 확인해 볼 수 있습니다. Davi 플러그인은 깃허브에 오픈소스로 공개돼 있고 아파치 2.0(Apache 2.0) 라이선스라 상업적 이용과 수정, 재배포가 모두 가능합니다. Claude Code에 추가하면 Davi가 작업마다 Haiku, Sonnet, Opus 중 알맞은 모델을 골라 맡깁니다.
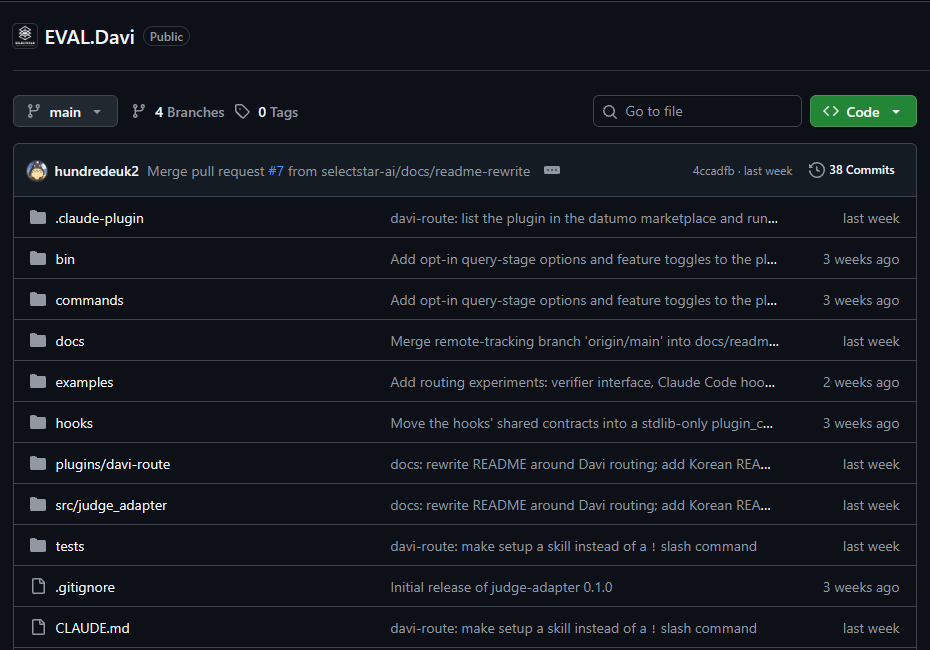
셀렉트스타가 깃허브에 공개한 Davi 라우팅 플러그인 저장소. 출처: GitHub selectstar-ai/EVAL.Davi
이번 글에서 살펴본 비교는 셀렉트스타 AI 연구팀이 같은 조건에서 직접 수행한 결과입니다. 특히 한국어 루브릭 평가와 모델 라우팅에서 차이가 분명하게 드러났는데요. 우리 서비스에 쓰려는 판정 모델이 한국어 답변을 얼마나 정확히 가려내는지 궁금하시다면, 같은 기준으로 확인해 보세요.