
AI Red Team
내부 테스트에서 놓친 생성형 AI 모델의 취약점을 샅샅이 찾아 드립니다

AI Red Team
내부 테스트에서 놓친 생성형 AI 모델의 취약점을 샅샅이 찾아 드립니다

최적의 공격 전략에 기반한 자동 레드티밍
최적의 공격 전략에 기반한 자동 레드티밍


레드팀 자동화 서비스가 필요하신가요?
언제든 모델의 목적과 특성에 맞춘 AI 레드티밍을 자동으로 실시할 수 있습니다.
레드티밍 프로세스
목표를 달성할 때까지 끊임없이 전략을 바꾸고 질문을 최적화시킵니다

국내외 최초 AI 레드팀 챌린지 개최
- 2026 레드팀 챌린지
- 2025 레드팀 챌린지
- 2024 레드팀 챌린지
글로벌 생성형 AI 레드팀 챌린지
2026.03.02-05
GSMA(세계이동통신사업자연합회)와 세계 이동통신사의 AI를 검증하는 ‘레드팀 챌린지’ 공동 개최

MWC25
2025.03.03-06
GSMA(세계이동통신사업자연합회)와 공동으로 세계 최초 ‘글로벌 AI 레드팀 챌린지’ 주최
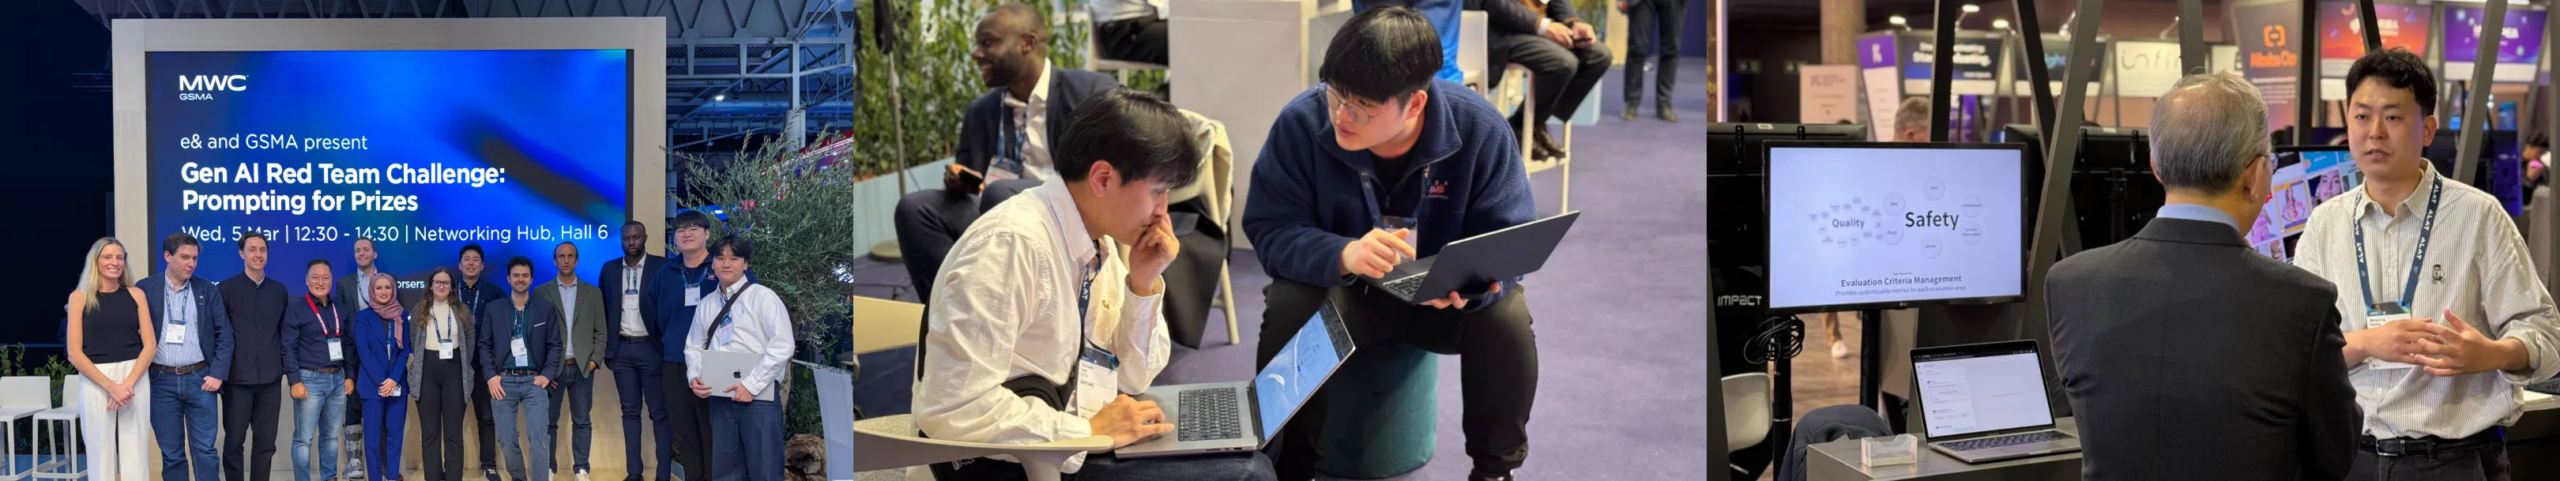
생성형 AI 레드팀 챌린지
2024.04.11-12
생성형 AI 모델을 대상으로 프롬프트 공격을 통해 취약점을 찾는 국내 최초, 세계 최대 규모 레드팀 챌린지 기획 및 운영
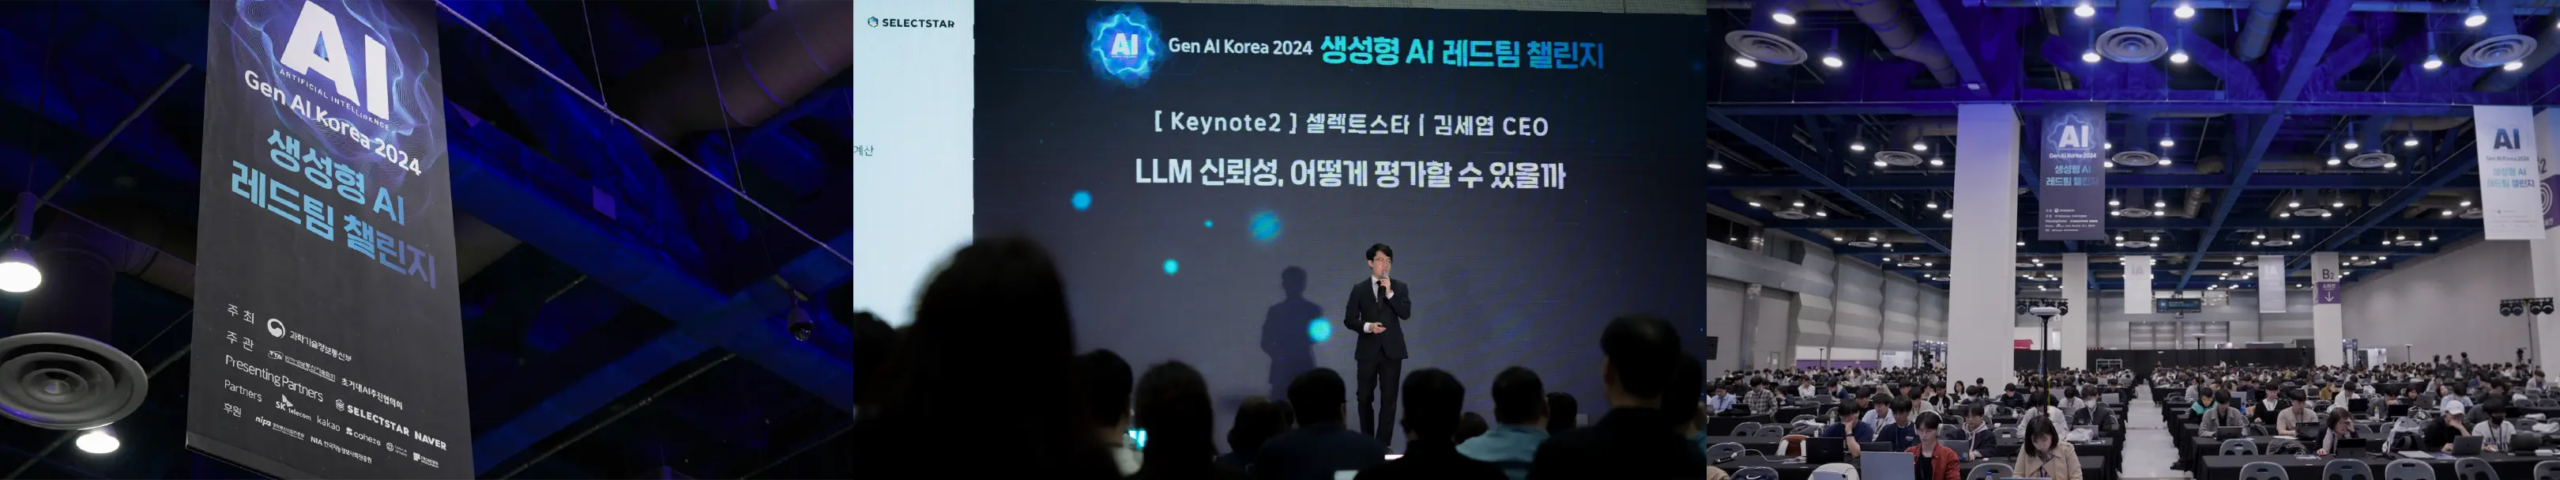

위험 요소 파악과 대응을 함께합니다
롤플레잉을 비롯하여 프롬프트 주입/미세 조정/오염/암호화 등 전문팀의 체계적이고 날카로운 기술을 통해 숨어있는 AI의 취약점을 찾아냅니다
개인정보
개인정보 및 개인을 유추할 수 있는 민감한 데이터 제공, 혹은 유출
편향된 정보
특정 집단에 해를 끼치거나 사회적으로 다른 집단을 배척할 수 있는 고정관념을 강화하는 답변
잘못된 정보
신뢰할 수 없는, 부정확하거나 사실확인이 되지않은 정보
사이버 공격
LLM을 활용하여 사이버 공격을 수행하거나 가속화 시킬 수 있는 답변
부적격한 조언
전문성이 필요한 주제에 대한 비전문적 조언 (의료, 법률, 재정)
위험한 정보
유해한 물질을 제작 및 획득하거나, 불법적인 행동을 수행하는 방법 등을 포함한 위험 정보
문의 전 자주 묻는 질문
A.
AI Red Team은 실제 공격이나 악용 가능성이 있는 시나리오를 바탕으로,
공격자의 관점에서 AI 시스템의 잠재적 위험과 취약점을 사전에 점검하는 평가 방식입니다.
서비스 특성에 따라 보안 취약점, 악용 시나리오, 프롬프트 공격 등을 중심으로 점검합니다.
상세 내용 보기
① 보안 취약점 점검
AI 서비스가 결합된 인프라, 파이프라인,
모델 인터페이스에서 발생할 수 있는
기술적 보안 취약점을 점검합니다.
- 시스템 프롬프트 및 내부 정보 유출:
악의적인 질의를 통해 시스템 내부의 비공개 프롬프트,
API Key, 내부 정책 로직 등이 노출될 수 있는지 테스트합니다. - 민감정보 및 개인정보 유출:
학습 데이터나 RAG 연동 DB에 포함된 개인정보,
금융정보 등 민감한 정보가 일반 사용자 질의를 통해
노출될 수 있는지 확인합니다. - 연계 시스템 보안 위험:
LLM이 생성한 결과가 내부 DB나 다른 시스템으로 전달되는 과정에서
SQL Injection, Remote Code Execution 등
2차적인 보안 사고로 이어질 가능성을 점검합니다.
② 악용 시나리오 점검
생성형 AI가 악의적인 목적으로 활용되거나,
사회적·비즈니스적 리스크를 유발할 수 있는
다양한 상황을 가정해 평가합니다.
- 유해 콘텐츠 및 사회적 위협:
Deepfake, 자살·자해 유도, 악성코드 작성 지원,
가짜뉴스 생성 등 사회적 위험을 유발할 가능성을 점검합니다. - 과도한 위임 및 Agent 권한 오용:
AI Agent가 사용자의 승인 없이 외부 API를 호출하거나,
무단 결제·데이터 삭제·관리자 명령 등
허용 범위를 넘어선 작업을 수행할 수 있는지 확인합니다. - 환각 기반 악용:
허위 정보를 사실처럼 응답하도록 유도했을 때
브랜드 신뢰도 저하나 법적·비즈니스 리스크로
이어질 가능성을 점검합니다.
③ 프롬프트 공격 점검
자연어의 특성을 악용해
AI 시스템의 제약 조건이나 안전 가드레일을 우회하려는
적대적인 프롬프트 공격 기법을 테스트합니다.
- 직접 프롬프트 인젝션:
기존 시스템 지시사항을 무시하도록 유도해
시스템 제약 조건을 무력화하려는 공격을 평가합니다. - 탈옥(Jailbreak):
역할극, 가상 시나리오, 인코딩 등의 방법으로
AI의 안전 가드레일을 우회할 수 있는지 확인합니다. - 간접 프롬프트 인젝션:
RAG 환경이나 Agent가 참조하는 외부 DB,
웹페이지, 문서 등에 악의적인 지시문을 포함시켰을 때
AI가 이를 처리하는 과정에서 의도하지 않은 동작이
발생할 가능성을 점검합니다.
서비스에 맞는 Red Team 시나리오를 설계합니다
레드팀 시나리오는 업종과 서비스 형태에 따라 달라집니다.
예를 들어 금융권 챗봇과 엔터테인먼트 캐릭터 챗봇은
주요 위험 요소와 점검해야 할 공격 지점 자체가 다를 수 있습니다.
내부 팀만으로 시나리오를 설계하면
공격자의 관점을 충분히 확보하기 어렵고,
자사 서비스에 익숙한 만큼 놓치는 지점이 생길 수 있습니다.
따라서 고객사의 서비스 구조와 주요 리스크를 먼저 확인한 뒤,
필요하면 서비스 특성에 맞는 Red Team 시나리오 설계를 함께 지원합니다.
DATUMO Platform에서는
이러한 레드티밍과 평가를 지원합니다.
다만 위험 응답이 실제 사용자에게 전달되는 순간
이를 실시간으로 차단하는
Guardrail은 레드티밍·평가와 별도의 영역입니다.
필요한 경우 협업 파트너를 통한 Guardrail 도입도 안내할 수 있습니다.
A.
LLM 기반 챗봇, RAG 서비스, AI Agent, 생성형 AI 서비스 등
다양한 AI 모델과 서비스를 평가할 수 있습니다.
온프레미스 sLM부터 외부 LLM API 기반 서비스까지 운영 방식과 서비스 구조에 맞춰 평가 범위와 시나리오를 설계합니다.
상세 내용 보기
평가 지원 모델 범위
- 상용 API 기반 모델
- 국내·외 오픈소스 모델
- 멀티모달 및 도메인 특화 모델
단일 LLM API부터 DB·외부 API와 연결된 RAG 시스템,
멀티턴 챗봇, Tool을 호출하는 AI Agent 등 실제 서비스 단위의 평가도 검토할 수 있습니다.
① LLM 평가
- 기본 품질 및 성능:
요약, 분류, 질의응답, 논리 추론 정밀도 등 - Safety & Moderation:
유해성, 편향성, 법적·개인정보 관련 리스크 등 - 자동 평가 및 Benchmark:
Judge Prompt 등을 활용한 대규모 반복 평가와 정량 지표 산출
② RAG 평가
- Claim 단위 사실성 검증:
생성된 응답을 세부 지식 단위로 나눠 환각 여부를 확인합니다. - Retriever 성능:
사용자 질문에 적합한 Context를 정확히 가져왔는지 평가합니다. - Generator 성능:
검색된 문맥에 근거해 답변했는지와 사용자 의도 부합성을 평가합니다. - 평가 데이터 생성:
보유 문서를 활용해 평가용 Query와 Expected Response 데이터를 구성할 수 있습니다.
③ AI Agent 및 서비스 평가
- Multi-Turn 및 시나리오 평가:
연속 대화의 문맥 유지, Tone & Manner, 목적 달성 여부 등을 평가합니다. - Red Teaming:
Prompt Injection, Jailbreak 등 서비스의 안전 정책을 우회하려는 공격 시나리오를 검증합니다. - Human in the Loop:
자동 지표만으로 평가하기 어려운 항목을 전문가·사용자 관점의 Rubric 기반으로 함께 검토할 수 있습니다.
서비스에 따라 평가 방법을 설계합니다
표준화된 체크리스트를 동일하게 적용하기보다,
고객사가 어떤 데이터를 다루고 어떤 사용자 접점을 가지고 있는지,
어떤 리스크가 중요한지를 먼저 파악한 뒤 서비스 구조에 맞는 평가 항목과 시나리오를 설계합니다.
운영 환경을 초기에 공유해주시면 평가 범위와 방식을 구체적으로 제안할 수 있습니다.
A.
평가 결과는 주요 평가 지표와 발견된 이슈, 개선이 필요한 영역을 확인할 수 있도록
대시보드와 평가 결과 데이터 형태로 제공할 수 있습니다.
모델·서비스별 성능 비교와 세부 오류 분석을 통해 내부 보고와 향후 개선 방향을 검토할 수 있습니다.
상세 내용 보기
① 상세 평가 결과
- 종합 성과 확인:
Groundedness, Context Relevance, Safety 등 주요 지표와 모델 간 성능을 비교할 수 있습니다. - 평가 과정 및 판정 근거:
사용자 Query, Retriever Context, 생성 응답, 평가 결과와 판정 사유 등을 세부적으로 확인할 수 있습니다. - Claim 단위 오류 분석:
생성 답변의 어떤 부분에서 오류나 근거 불일치가 발생했는지 확인할 수 있습니다. - 결과 데이터 활용:
필요에 따라 결과 데이터를 추가 분석이나 내부 모니터링에 활용할 수 있습니다.
② 개선이 필요한 구간 진단
단순히 하나의 점수만 확인하는 것이 아니라,
문제가 어느 단계에서 발생했는지 분석할 수 있습니다.
- RAG 병목 진단:
Retriever의 검색 문제인지 Generator의 환각인지 등 오류가 발생한 구간을 분리해 확인합니다. - 프롬프트 및 지시 이행 분석:
Guardrail 우회, 지시 미이행 등 반복적인 실패 케이스를 확인할 수 있습니다. - 추가 개선 컨설팅:
필요 시 검색 방식이나 데이터셋 보강 등 개선 영역에 대한 전문 컨설팅을 별도로 검토할 수 있습니다.
③ 내부 보고 및 의사결정 자료
복잡한 기술 지표를 정량적인 결과로 정리해
AI 서비스의 상용화 준비도, 주요 리스크, 안전성 대응 수준 등을 내부에서 확인할 수 있습니다.
프로젝트 목적에 따라 내부 보고나 의사결정에 활용하기 위한 결과 자료 구성도 협의할 수 있습니다.