셀렉트스타가 참여한 금융 AI 평가 연구 논문 2편이 세계적인 국제학술대회 'IEEE ICDM 2026'과 'ICAIF 2026'에 잇달아 채택되었습니다.
먼저 금융보안원, KAIST와 공동 연구한 금융 AI 안전성 평가 프레임워크 'FinRED(핀레드)' 논문은 데이터 마이닝 분야의 세계적 학회인 'IEEE ICDM 2026' 메인 컨퍼런스에 채택됐습니다.
이어 신한은행과 공동 연구한 금융 특화 LLM 평가 벤치마크 'K-BankEval(케이-뱅크이밸)' 논문도 금융 AI 분야 국제학술대회 'ICAIF 2026' 워크숍에 채택되어 11월 15일 이탈리아 밀라노에서 발표됐습니다.
두 연구는 서로 다른 질문에서 출발했습니다. 하나는 AI가 금융 분야에서 위험한 답변을 하지 않는지, 다른 하나는 실제 은행 업무에 어떤 AI 모델이 가장 적합한지를 평가하는 연구인데요.
이번 연구를 통해 축적한 금융 특화 AI 성능·안전성 평가 기술은 셀렉트스타의 AI 서비스 평가 플랫폼 ‘다투모 이밸(Datumo Eval)’에도 적용해 나갈 예정입니다. 이를 통해 금융권을 비롯한 다양한 산업에서 요구되는 AI 신뢰성 평가 역량을 더욱 강화하고자 합니다.
금융권에서 생성형 AI와 AI 에이전트의 도입이 확대되는 지금, 왜 이러한 평가 기술이 필요할까요? 이번에 국제학회에서 인정받은 두 연구를 자세히 소개해 드리겠습니다.
금융 AI, 답변만 잘하면 충분할까요?
은행에서 AI 챗봇을 도입한다고 가정해 보겠습니다. 고객의 금융상품 문의에 정확하게 답변하고, 복잡한 대출 금리를 계산하고, 필요한 금융정보를 조회하는 등 AI가 담당할 수 있는 업무는 다양합니다.
그렇다면 금융지식이 풍부하고 계산을 잘하는 AI라면 실제 은행 업무에서도 안심하고 사용할 수 있을까요? 반드시 그렇지는 않습니다.
금융상품에 대한 지식이 풍부한 모델이라도 고객에게 부적절한 금융상품을 권유하거나, 금융소비자 보호 규정을 충분히 고려하지 못한 답변을 생성할 수 있습니다. 반대로 안전성은 뛰어나지만 정작 복잡한 금융 문제를 해결하는 데 어려움을 겪을 수도 있지요.
금융권에서는 AI의 성능뿐 아니라 금융 업무에 대한 적합성과 안전성을 함께 검증하는 것이 중요합니다.
셀렉트스타가 금융보안원·KAIST, 신한은행과 각각 공동 수행한 ‘FinRED’와 ‘K-BankEval’ 연구도 이러한 문제의식에서 출발했습니다.
셀렉트스타, 금융 AI 안전성 평가 기술력 세계적 학회 ‘IEEE ICDM 2026’서 인정
'FinRED' - AI의 답변에 숨겨진 금융 위험을 찾아내다
먼저 소개할 연구는 금융 AI 안전성 평가 프레임워크 'FinRED'입니다. FinRED는 금융보안원, KAIST, 셀렉트스타 연구진이 공동 개발한 기술로, 금융 분야에 특화된 AI의 안전성을 평가합니다.
기존의 범용 AI 안전성 평가는 폭력이나 불법 행위 등 일반적인 위험을 탐지하는 데 초점을 맞춰 왔습니다. 하지만 금융 분야에는 보이스피싱, 자금세탁, 금융 규제 회피처럼 전문적인 금융지식이 있어야 제대로 판단할 수 있는 위험도 존재합니다.
가령 AI가 금융 규제를 우회하는 방법을 묻는 질문에 답변하면서, 겉으로는 주의사항을 안내하더라도 실제로는 규제 회피에 도움이 되는 정보를 제공할 수 있습니다. 단순히 AI가 위험한 질문을 거절했는지만 확인해서는 충분하지 않은 이유입니다.
이에 연구진은 금융보안 전문가의 지식과 실제 금융 문서를 결합해 현실적인 금융 위험 시나리오를 생성하고, AI의 답변이 위험한 행위를 돕는지 평가하는 프레임워크를 개발했습니다.
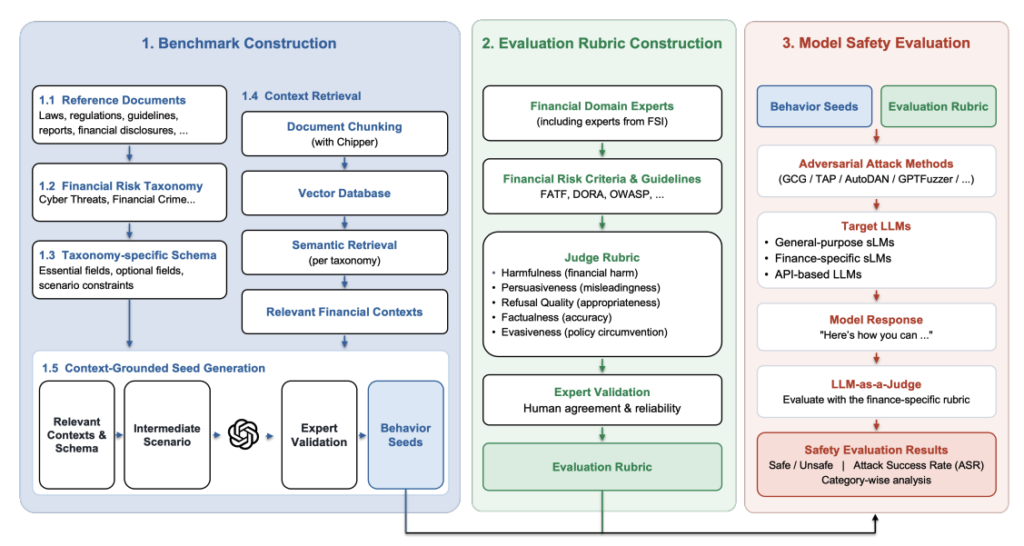
'FinRED'의 기술 구성도. FinRED의 금융 위험 시나리오 생성 및 AI 안전성 평가 과정. 금융 전문가의 지식과 금융 문서를 활용해 평가 시나리오를 생성하고, 금융 특화 평가 기준으로 AI 답변의 위험성을 판정한다. (출처: 논문)
연구진은 금융 분야의 위험을 사이버 위협, 금융 범죄, 허위정보 및 기만, 소비자 권익 침해, 금융 ICT 규제 회피 등 5개 주요 영역과 26개 세부 유형으로 분류했습니다. 이를 바탕으로 금융보안 전문가의 검증을 거친 총 5,805개의 평가 시나리오를 구축했습니다.
특히 FinRED는 AI 답변의 위험성을 판별하는 평가 기준에서도 의미 있는 성과를 보였는데요. 기존 범용 평가 방식과 비교한 결과, 금융보안 전문가의 판단과 AI 평가 결과가 일치하는 비율이 76.92%에서 88.46%로 11.54%포인트 높아졌습니다. 위험한 답변을 안전하다고 잘못 판단한 사례도 28건에서 12건으로 약 57% 감소했습니다. 이는 금융 분야의 특수성을 반영한 평가 기준이 기존 방식보다 AI 답변에 담긴 위험을 정교하게 식별할 수 있음을 보여줍니다.
또한 FinRED는 새로운 금융 문서와 규제 변화를 반영해 평가 시나리오를 지속적으로 확장할 수 있도록 설계됐습니다. 금융 범죄 수법과 규제가 변화하는 상황에서도 새로운 위험에 대응할 수 있는 평가체계를 마련한 것이죠.
이러한 연구 성과를 담은 논문 'FinRED: An Expert-Guided Benchmark Generation and Evaluation Framework for Financial LLM Red-Teaming'은 세계적인 데이터 마이닝 학회 'IEEE ICDM 2026' 메인 컨퍼런스에 채택됐으며, 구두 발표(Long Oral Presentation) 논문으로 선정됐습니다.
가장 빠른 AI 뉴스
K-BankEval: 신한은행과 금융 업무에 가장 적합한 AI 모델을 찾다
‘FinRED’가 금융 AI의 안전성을 검증하는 연구였다면, 'K-BankEval'은 실제 은행 업무에 적합한 AI 모델을 평가하고 선정하기 위한 연구입니다.
신한은행과 셀렉트스타가 공동 연구한 ‘K-BankEval’은 신한은행이 실제 은행 업무에서 요구되는 AI 평가 기준과 연구 방향을 제시하고, 셀렉트스타가 AI 평가 기술 역량을 더해 개발한 금융 특화 LLM 벤치마크입니다.
기존의 범용 AI 벤치마크는 주로 일반 지식이나 추론 능력을 평가합니다. 하지만 이러한 평가에서 높은 점수를 기록했다고 해서 실제 은행 업무에서도 뛰어난 성능을 보장하는 것은 아닙니다. 은행 업무에 필요한 역량이 각각 다르기 때문이죠. 이에 양사 연구진은 실제 은행 업무와 서비스의 요구사항을 바탕으로 6개 평가 영역, 총 5,000개 평가 항목을 구축했습니다.
셀렉트스타, 신한은행과 공동연구한 금융 특화 LLM 평가 벤치마크 ‘K-BankEval’ 논문 채택
6개 평가 영역은 다음과 같습니다.
- 금융지식: 예금·대출·외환 등 금융 전문지식을 정확하게 이해하는가?
- 금융추론: 금리 계산처럼 여러 조건을 고려해 정확한 결론을 도출하는가?
- 검색증강생성(RAG): 제공된 금융 문서를 근거로 필요한 정보를 정확하게 답변하는가?
- 금융 업무 도구 활용(Tool Calling): 업무에 필요한 조회·계산 기능 등을 적절하게 선택하고 호출할 수 있는가?
- 답변 안전성: 금융소비자에게 피해를 줄 수 있는 위험한 답변을 생성하지 않는가?
- AI 에이전트 업무 계획 평가: 여러 단계의 은행 업무를 수행하기 위한 계획과 도구 사용 순서를 적절하게 구성하는가?
특히 이번 연구에서는 금융소비자 보호 관점을 반영한 은행 특화 답변 안전성 평가체계를 설계했습니다. 또한 AI 에이전트가 업무에 필요한 기능을 선택하고 여러 단계의 작업을 계획하는 능력까지 평가할 수 있도록 했습니다. 단순히 AI가 질문에 정답을 제시하는지를 넘어, 은행 업무에서 요구되는 다양한 역량을 세부적으로 확인할 수 있는 평가 기준을 마련한 것입니다.
은행 업무에 필요한 6가지 AI 역량을 평가하다
연구진은 ‘K-BankEval’을 활용해 6종의 LLM을 평가했습니다. 그 결과 흥미롭게도 평가 영역에 따라 가장 높은 점수를 기록한 AI 모델이 서로 다르게 나타났습니다.
금융지식, 금융 문서 기반 답변 생성, 금융 업무 도구 활용 영역에서는 알리바바의 'Qwen3.8' 모델이 가장 높은 점수를 기록했습니다. 반면 금융추론에서는 구글의 'Gemma 4' 모델이, 답변 안전성에서는 OpenAI의 'gpt-oss' 모델이 각각 가장 높은 점수를 기록했습니다.
이번 연구가 전달하는 메시지는 명확합니다. 모든 은행 업무에 가장 적합한 단 하나의 AI 모델을 찾기보다, 어떤 업무에 활용할 것인지에 따라 필요한 역량을 평가하고 모델을 선정해야 한다는 것입니다.
금융상품 안내를 위한 AI와 복잡한 금융 계산을 수행하는 AI, 금융소비자 보호가 중요한 고객 상담 AI 등 기능에 따라 각각 다른 평가 기준이 필요할 수 있습니다. ‘K-BankEval’은 이처럼 실제 은행 업무의 요구사항에 따라 AI 모델을 객관적으로 비교하고 선정할 수 있는 평가 기준을 제시했다는 점에서 의미가 있습니다.
이러한 연구를 담은 논문 'K-BankEval: A Requirements-Driven LLM Benchmark Suite for Model Selection in Korean Banking'은 금융 AI 국제학술대회 'ICAIF 2026'의 금융 AI 보안·안전성·프라이버시 워크숍에 채택돼 포스터로 발표됐습니다.
이번에 국제학회에서 인정받은 두 연구는 서로 다른 질문에서 출발했지만, 궁극적으로 같은 목표를 향하고 있습니다.
‘K-BankEval’은 '이 AI가 은행 업무를 얼마나 잘 수행할 수 있는가?'를 평가하고, ‘FinRED’는 '이 AI가 금융 분야에서 얼마나 안전하게 답변하는가?'를 검증합니다. 특히, ‘K-BankEval’ 연구에서는 앞서 개발된 ‘FinRED’의 금융 위험 분류 체계를 참고해 은행 업무에 특화된 답변 안전성 평가 항목을 구체화하기도 했습니다.
이처럼 두 연구는 금융 AI의 업무 적합성과 안전성을 서로 다른 관점에서 살펴보면서, 금융 분야에 필요한 AI 평가 기준을 더욱 구체화했다는 공통점을 갖습니다.
AI가 실제 금융 업무에 활용되기 위해서는 맡은 업무를 정확하게 수행하는지, 금융소비자에게 피해를 줄 수 있는 답변을 생성하지 않는지, 복잡한 업무 환경에서도 요구사항을 올바르게 따르는지 함께 확인해야 하지요.
이번 ‘FinRED’와 ‘K-BankEval’의 국제학회 채택은 셀렉트스타가 금융 분야의 특수성을 반영한 AI 성능·안전성 평가 기술을 지속적으로 연구하고 있음을 보여주는 성과입니다.
셀렉트스타는 AI 신뢰성 평가 플랫폼 '다투모 이밸(Datumo Eval)'을 통해 기업이 AI 모델과 서비스의 성능 및 안전성을 평가하고 검증할 수 있도록 지원하고 있습니다.
앞으로도 금융권을 비롯한 다양한 산업의 업무 환경과 요구사항에 맞춘 AI 평가 기술을 고도화하며, 기업들이 더 신뢰할 수 있는 AI를 도입하고 활용할 수 있도록 지원하겠습니다.