[K-AI 평가 1편] K-AI는 정말 한국어를 잘할까? 국가대표 모델의 국어 능력 평가

[K-AI 평가 1편] K-AI는 정말 한국어를 잘할까? 국가대표 모델의 국어 능력 평가

'소버린 AI'라는 말, 요즘 자주 들으셨을 텐데요. 우리 언어와 문화를 제대로 이해하는 AI를 우리 기술로 만들자는 흐름이지요. (소버린 AI가 무엇인지는 지난 글에서도 다뤘습니다.) 정부는 K-AI 독자 파운데이션 모델 프로젝트로 국가대표 모델을 키우고 있고, 참여 기업들은 새 모델을 낼 때마다 성능 지표를 내놓고 있습니다.

셀렉트스타는 IT 전문 매체 디지털데일리와 함께 이 모델들을 평가하는 기획을 시작했습니다. 디지털데일리 기사에 이어, 이 블로그에서는 평가를 어떻게 설계했고 그 과정에서 무엇이 보였는지를 더 자세히 풀어 보려 합니다.
독자 AI 파운데이션 모델 프로젝트 결과 발표 출처 - 과학기술정보통신부

최근 독파모 2차 평가 결과가 공개되면서 '무엇을 기준으로 평가해야 하는가'가 새로운 화두로 떠올랐습니다. 벤치마크 점수와 전문가, 사용자 평가가 서로 다른 결과를 가리켰고 평가 기준을 더 투명하게 공개하라는 요구도 이어졌지요. 점수 하나만으로는 모델을 판단하기 어렵다는 걸 보여 준 장면입니다. 이번 기획도 같은 고민에서 출발했습니다. 셀렉트스타 AI 연구팀은 모델에 순위를 매기기보다, 소버린 AI를 평가할 때 무엇을 더 봐야 하는지 그 기준을 제시하는 데 초점을 맞췄습니다.

시리즈는 세 가지 질문으로 이어집니다. 한국어를 정말 아는지, 일을 맡겨도 되는지, 공격에 버틸 수 있는지입니다. 세 편을 따라오시면 벤치마크 점수가 높은 모델과 믿고 쓸 수 있는 모델이 어디서 갈리는지 보이실 겁니다.

  1. K-AI는 정말 한국어를 잘할까? (국어 능력 평가) <- 이번 글
  2. K-AI는 실제 일도 잘할까? (한국어부터 행동, 업무 수행까지)
  3. K-AI는 어떤 공격에 약할까? (유형별로 드러난 안전성 취약점)

참여 기업들이 가장 앞세우는 지표는 한국어 벤치마크 점수입니다. 업스테이지는 Solar Open 2를 공개하며 한국어 평가에서 GPT-5.4 미니, 클로드 하이쿠 4.5보다 높은 성능을 보였다고 밝혔습니다. LG AI연구원은 K-엑사원 2.0의 한국어 장문 이해 평가(Ko-LongBench) 점수를 중국 지푸의 GLM-5.1과 나란히 놓고 비교했고요. SK텔레콤은 A.X K2가 수학과 한국어 영역에서 특히 두드러진 성과를 냈다고 소개했습니다. 모델의 실력을 가늠하는 데 꼭 필요한 숫자들입니다.

그런데 '한국어를 잘한다'는 걸 점수 하나로 다 잴 수 있을까요? 점수는 모델이 몇 문제를 맞혔는지 알려 줍니다. 하지만 같은 문제를 다시 물어도 같은 답을 내는지, 틀렸다면 어디서 왜 틀렸는지까지는 알려 주지 않지요.

그래서 셀렉트스타 연구팀은 같은 문제를 여러 번 풀게 하고 모델이 남긴 사고 과정까지 함께 읽었습니다. 정답률 너머, 모델이 얼마나 일관되게 답하는지, 답에 이르기까지 어떻게 생각하는지까지 들여다본 것이지요. 오늘은 수능과 공무원 시험 등에서 모은 국어 문제 2,285개로, 한국어 능력을 평가하는 세 가지 관점을 소개하겠습니다.

관점 1. '한국어 특화'가 국어 실력까지 보장하진 않는다

K-AI 모델들은 저마다 '한국어 특화'를 내세웁니다. 한국어 데이터를 충분히 학습했고 한국어 벤치마크에서도 좋은 점수를 받았다는 뜻이지요. 하지만 한국어를 많이 접했다고 해서 한국어의 문법과 의미 체계까지 정확히 안다고 할 수 있을까요?

이 질문에 답하려면 한국어 능력을 둘로 나눠 봐야 합니다. 쓰는 능력은 문서를 요약하고 질문에 답하는 것처럼 한국어로 일을 해내는 능력입니다. 아는 능력은 한국어의 문법과 의미 체계를 이해하고 그걸 바탕으로 정확하게 판단하는 능력이고요. 기업들이 앞세우는 한국어 종합 점수는 대부분 지식, 독해, 업무 수행을 한데 묶은 것이라 쓰는 능력에 가깝습니다.
한국어를 배우는게 어려운 외국인과 한국어가 쉬운 한국인. 출처 - AI 생성

두 능력이 따로 움직일 수 있다는 건 한국어를 배우는 외국인을 떠올리면 쉽게 알 수 있습니다. 우리는 '은/는'과 '이/가'의 차이를 설명하지 못해도 틀리지 않고 씁니다. 반면 규칙부터 익힌 외국인 학습자가 한국인보다 문법을 더 정확하게 설명하기도 합니다. 많이 써 봤다고 해서 규칙까지 아는 건 아닌 셈입니다.

연구팀은 '한국어 특화'라는 이름에 걸맞으려면 한국어로 일을 잘하는 것은 물론이고 한국어의 규칙과 의미 체계도 정확히 알아야 한다고 봤습니다. 국가대표 모델들은 한국어를 '아는' 능력도 그만큼 갖추고 있을까요?
관점 2. 세 영역으로 나눠 본 '아는' 능력

'아는' 능력도 하나의 점수로 묶으면 어디가 강하고 어디가 약한지 보이지 않습니다. 연구팀은 이를 언어 구조 및 체계, 의미 및 맥락 이해, 추론 및 판단의 세 영역으로 나눠 2,285문항으로 측정했습니다.

평가 영역
무엇을 묻나
예시 문제
무엇이 관건인가

언어 구조 및 체계

소리(음운), 단어(형태), 문장(통사)의 규칙

'나뭇잎'은 왜 [나문닙]으로 발음할까?

'먹었다'는 어떤 형태소로 나뉠까?

어떤 문장이 안긴문장일까?

어문 규정과 사전에 정해진 규칙을 정확히 알고 적용하는지

의미 및 맥락 이해

단어와 문장의 뜻(의미), 대화 속 의도(화용), 긴 글의 내용 파악(독해)

"내일 날씨 어떻대?"에 "무릎이 쑤시네"라고 답한 뜻은 무엇일까?

'물 건너온 범'은 어떤 상태를 뜻할까?

규칙보다는 실제 언어 사용 경험이 쌓여 있는지

추론 및 판단

자료 해석, 논리 추론, 규정의 사례 적용, 논증 평가

주어진 조건들을 조합하면 어떤 결론이 나올까?

한국어로 주어진 내용을 정확히 이해하고(아는 능력) 이를 바탕으로 결론까지 끌어내는지(쓰는 능력)

문항은 수능과 모의고사, 5급과 7급 공무원 시험, 검정고시 등 실제 시험에서 모았고 KoGEM, KoBALT 같은 공개 벤치마크도 활용했습니다. 기존 벤치마크 문항 중 정답 오류나 결함이 있는 것은 걸러냈고, 모든 문항은 사람이 검수한 텍스트로 정리해 모델에 제공했습니다.

가장 빠른 AI 뉴스

영역마다 뒤바뀐 순위

비교 대상은 K-AI 프로젝트 참여 중 두 모델과 중국 모델(DeepSeek, Qwen), 미국 모델(GPT-5.5, Sonnet 5)입니다. 미국 모델 두 개는 글로벌 최상위 수준이라 기준선 역할을 합니다.
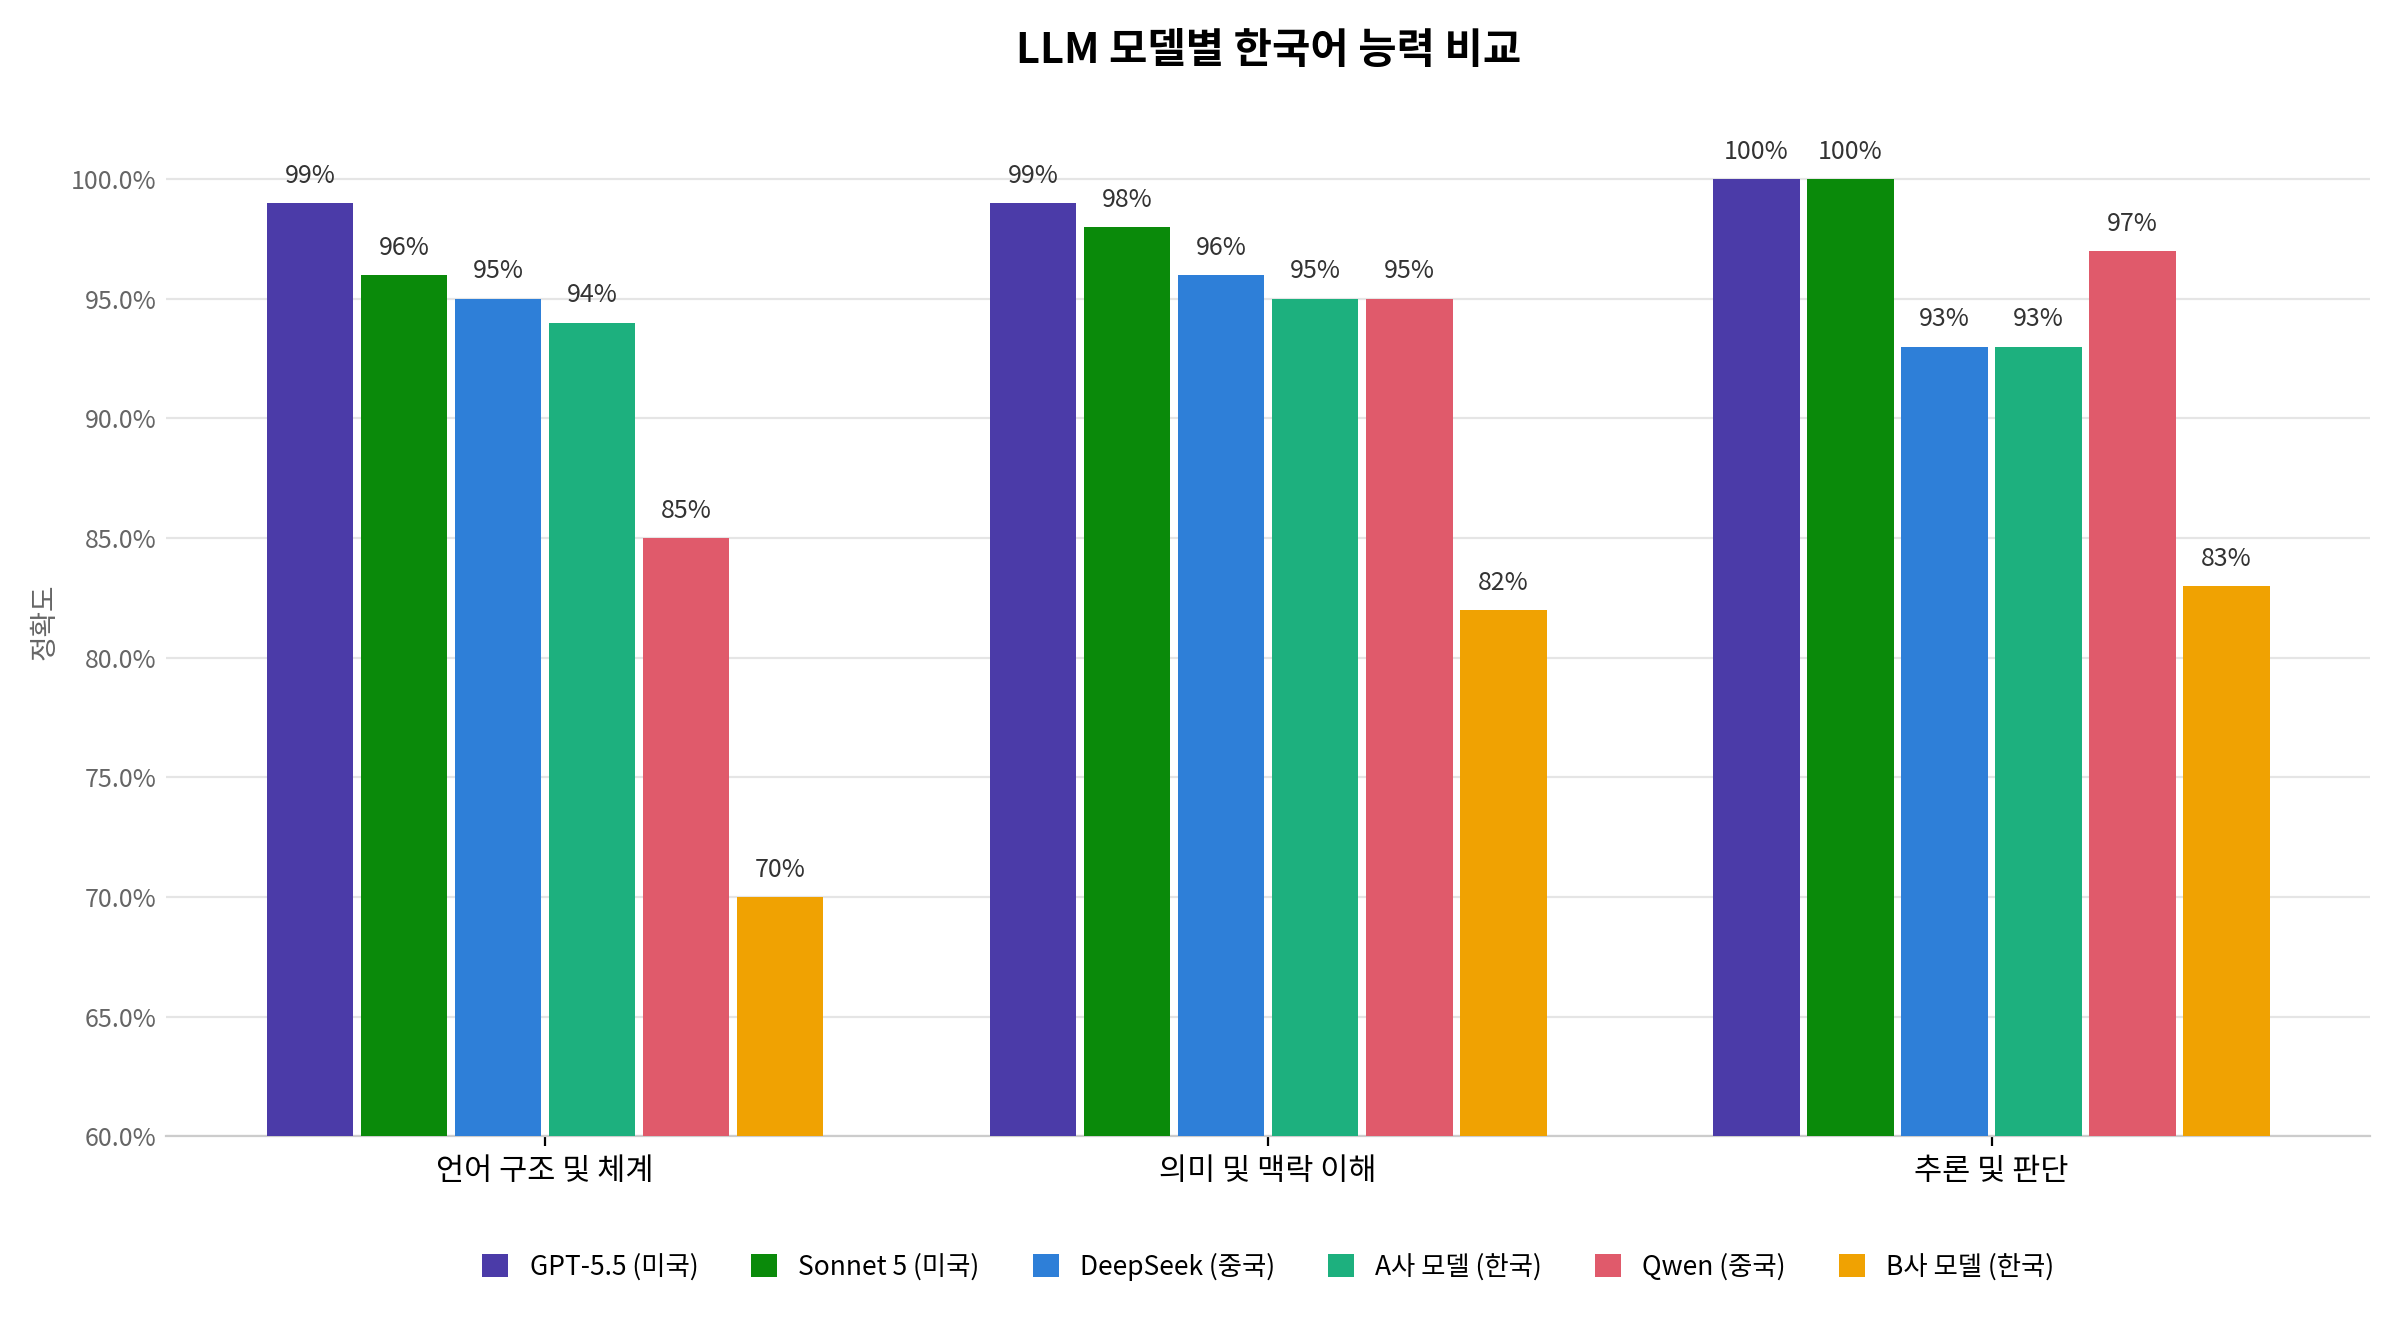
그림 - LLM 모델 별 한국어 능력 비교

수치는 같은 문제를 여러 번 풀게 한 뒤, 다수결로 정한 답을 기준으로 계산한 정답률입니다. 언어 구조 및 체계와 의미 및 맥락 이해는 기출 문제 모음, 추론 및 판단은 공무원 시험 언어논리 문항의 결과입니다.

글로벌 최상위 모델 두 개가 모든 영역에서 가장 높았고 그 아래에서는 영역마다 순위가 바뀌었습니다. 언어 구조 및 체계에서는 DeepSeek과 A사 모델이, 추론 및 판단에서는 Qwen이 앞섰지요. 종합 점수 하나였다면 보이지 않았을 차이입니다. 반면 B사 모델은 세 영역 모두에서 다른 모델보다 낮았고 특히 언어 구조 및 체계에서 격차가 가장 컸습니다. 실제 수능 문법 문항(최근 3년) 평균 점수도 DeepSeek 92점, A사 모델 80점, Qwen 70점, B사 모델 42점으로 크게 갈렸습니다.
관점 3. 점수 너머, 일관성과 사고 과정

점수표만 보면 여기서 이야기가 끝납니다. 하지만 이번 평가의 핵심은 지금부터입니다. 연구팀은 모델이 맞혔는지뿐 아니라 같은 질문에 일관되게 답하는지, 어디서 왜 틀리는지, 답에 이르기까지 어떻게 생각하는지를 함께 살펴봤습니다.

 
같은 문제, 다섯 번의 다른 답

가장 선명하게 드러난 것은 답의 일관성이었습니다. 아래는 언어 구조 및 체계 영역의 한 문제입니다.

다음 표준 발음법에 따라 발음하지 않은 것은?

  • 사이시옷 뒤에 ㄱ, ㄷ, ㅂ, ㅅ, ㅈ이 오면 뒤 자음을 된소리로 발음한다.
  • 사이시옷 뒤에 ㄴ, ㅁ이 오면 [ㄴ]으로 발음한다.
  • 사이시옷 뒤에 '이' 소리가 오면 [ㄴㄴ]으로 발음한다.

① 툇마루 [퇸마루] ② 나뭇잎 [나묻닙] ③ 샛길 [새낄]④ 냇가 [낻까] ⑤ 빨랫돌 [빨래똘]

정답은 ②번입니다. '나뭇잎'은 [나문닙]으로 발음해야 하지요. 규칙이 문제에 그대로 적혀 있으니 외우지 않아도 단어마다 대입해 보면 풀 수 있습니다.

연구팀은 같은 문제를 모델마다 다섯 번씩 풀게 했습니다. 대부분의 모델은 정답을 고르거나 틀리더라도 답이 특정 선택지로 모였는데요. B사 모델은 ⑤, ①, ③, ②, ④번을 차례로 골랐습니다. 다섯 번의 시도에서 다섯 개 선택지를 한 번씩 모두 고른 것이지요. 한 번만 풀게 했다면 맞혔을 수도, 틀렸을 수도 있는 문제입니다. 필요한 규칙이 눈앞에 있는데도 결과가 매번 달랐다는 건, 지식이 부족한 것을 넘어 판단 자체가 안정적이지 않다는 뜻입니다.

 
문법은 알아도, 관용 표현은 놓쳤다

약한 지점도 모델마다 달랐습니다. 대화의 의도를 묻는 문항에서는 A사 모델이 정답률 98%로 DeepSeek(94%)을 앞섰습니다. 반대로 문법에 강했던 DeepSeek은 관용 표현에서 같은 실수를 반복했지요.

밑줄 친 관용 표현이 문맥에 어울리지 않는 것은?

① 쇠털같이 많은 날에 왜 그리 서두릅니까?

② 그는 경기에 임하자 물 건너온 범처럼 맹활약을 하였다.

정답은 ②번입니다. '물 건너온 범'은 기세가 꺾인 상태를 뜻하니 '맹활약'과는 어울리지 않지요. 그런데 DeepSeek은 다섯 번 모두 ①번을 골랐습니다. '쇠털같이 많은 날'이 앞으로 살아갈 날이 많다는 뜻인 줄 모르고 글자 그대로 읽은 것입니다. 문법 점수가 높다고 한국어의 모든 면을 아는 것은 아니었습니다.

 
한국어로, 오래 생각한다고 답이 좋아지진 않았다

요즘 추론 모델은 답을 내기 전에 생각하는 과정(CoT, Chain of Thought)을 먼저 써 내려갑니다. 그렇다면 이 사고 과정을 한국어로 쓰는 모델이 한국어 문제도 더 잘 풀까요? 오래 생각할수록 정답에 가까워질까요?

이번 평가에서는 둘 다 그렇지 않았습니다. B사 모델은 수능 문법 문제를 풀며 사고 과정의 91%를 한국어로 썼습니다. 반면 비교한 다른 세 모델(DeepSeek, A사 모델, Qwen)은 사고 과정에서 한국어를 쓰는 비율이 18%를 넘지 않았습니다. 그런데도 세 영역 모두에서 더 높은 점수를 받은 쪽은 이 세 모델이었지요. 한국어로 생각한다는 것 자체가 한국어를 더 잘 이해한다는 뜻은 아니었던 셈입니다.

길이도 마찬가지였습니다. B사 모델은 출력이 2천 자 이하일 때 정답률이 80.5%였지만 5만 자를 넘기면 24.2%로 떨어졌습니다. A사 모델은 수능 음운 문제 두 개에서 각각 19만 자 가까이를 써 내려갔지만 두 번 모두 최종 답을 내지 못하고 멈췄고요.

물론 원래 어려운 문제라서 오래 고민하고 더 많이 틀렸을 수도 있습니다. 다만 이번 평가에서 지나치게 긴 출력은 깊은 생각의 증거라기보다 판단이 한 곳으로 모이지 못한다는 신호에 가까웠습니다. 어떤 언어로, 얼마나 오래 생각하느냐보다 그 판단을 정답까지 안정적으로 끌고 갈 수 있느냐가 더 중요했습니다.

마치며: 한국어 능력은 여러 겹으로 봐야 한다

한국어 벤치마크 점수는 모델의 실력을 가늠하는 중요한 출발점입니다. 다만 한국어를 '쓰는' 능력과 '아는' 능력은 다르고, '아는' 능력도 영역을 나누면 순위가 바뀝니다. 그리고 무엇보다 중요한 건 점수 너머에 있었습니다. 같은 질문에 일관되게 답하는지, 그 판단을 정답까지 안정적으로 끌고 갈 수 있는지는 점수표만으로는 보이지 않습니다. 국가대표 모델에 기대하는 게 믿고 쓸 수 있는 한국어 AI라면, 평가도 이런 질문까지 던져야 할 겁니다.

이번 글에서 소개한 평가 기준과 2,285개 문항은 셀렉트스타 AI 연구팀이 직접 설계하고 검수한 내부 벤치마크입니다. 우리 서비스에 쓰려는 모델이 한국어를 얼마나 제대로 알고 있는지, 같은 질문에 얼마나 일관되게 답하는지 궁금하시다면 같은 기준으로 확인해 보세요.

다음 글에서는 '한국어를 아는 것'을 넘어, 실제로 일을 맡겼을 때 모델들이 어떻게 판단하고 행동하는지 살펴보겠습니다.

Your AI Data Standard

점수 너머의 차이, 직접 확인하세요.
라이선스 이슈 없는 데이터셋 구매
Related Posts